在深度学习与人工智能的浪潮中,注意力机制(Attention Mechanism)已经成为绕不开的核心概念。无论是自然语言处理中的Transformer架构,还是计算机视觉里的图像识别模型,注意力机制都在其中扮演着关键角色。对于从事信息传输、软件开发、人工智能技术服务的企业和开发者而言,理解注意力机制的来龙去脉,不仅是掌握深度学习入门知识的必经之路,也是构建高质量AI应用的基础。本文将从注意力机制的基本思想出发,逐步深入到Transformer注意力机制的实现细节,并结合元学习算法、信息检索技术、强化学习、AirSim仿真、无人机仿真平台以及Fast.ai教程等实际场景,帮助读者建立完整的知识框架。
一、注意力机制为什么会出现:从信息瓶颈说起
传统的神经网络模型在处理序列数据时,往往依赖循环神经网络(RNN)或其变体LSTM、GRU。这类模型的核心问题在于:无论序列多长,最终都要压缩成一个固定长度的向量表示。当输入序列较长时,早期信息容易被稀释,形成所谓的信息瓶颈。注意力机制的提出,正是为了解决这一瓶颈——它允许模型在处理某个位置时,动态地“关注”输入序列中不同位置的信息,而不是被动地依赖一个固定表示。
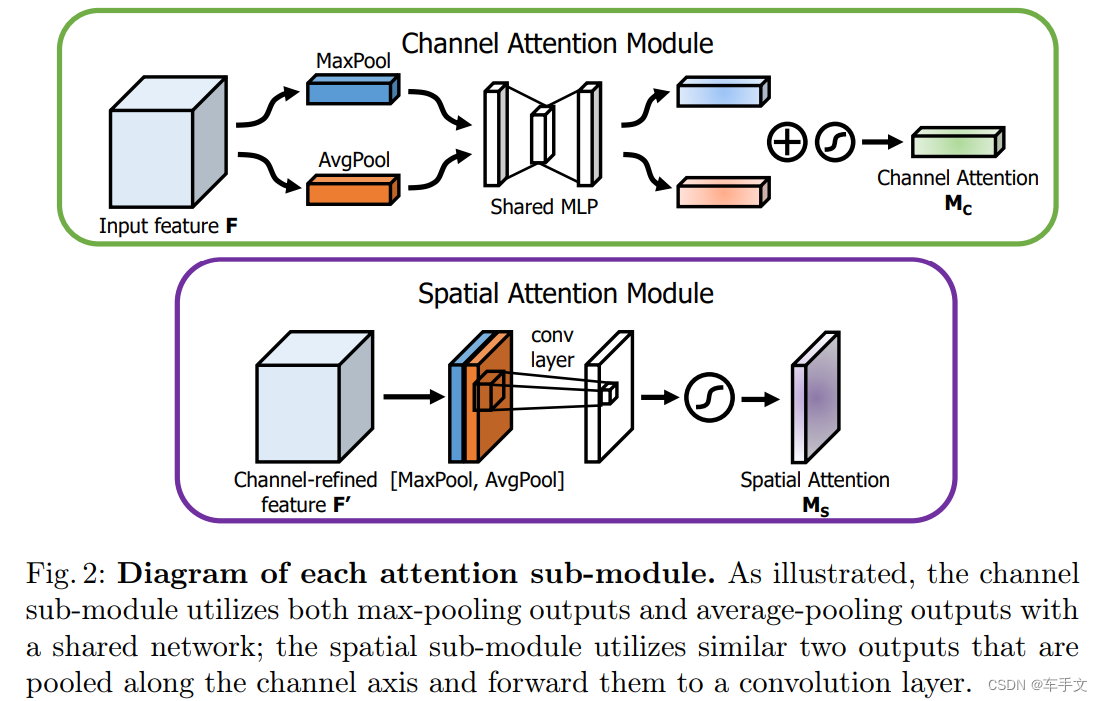
从直观上理解,注意力机制模拟了人类的认知过程:当我们阅读一段文字或观察一幅图像时,并不会平均分配注意力,而是会有选择地聚焦于关键部分。深度学习中的注意力机制正是将这种“选择性聚焦”数学化,通过计算查询(Query)与键(Key)之间的相似度,得到一组权重,再对值(Value)进行加权求和。这套逻辑看似简单,却衍生出了丰富多样的变体,成为现代深度学习模型的基础组件。
二、注意力机制的基本原理与数学表达
注意力机制的核心计算可以概括为三个步骤:打分、归一化、加权求和。给定查询向量Q、键矩阵K和值矩阵V,首先计算Q与每个键的相似度得分,常用的打分函数包括点积、缩放点积和加性模型;然后通过Softmax函数将得分转化为概率分布,即注意力权重;最后用这些权重对值向量进行加权求和,得到输出。
- 点积注意力:计算简单高效,适合大规模矩阵运算,是Transformer采用的形式。
- 缩放点积注意力:在点积基础上除以维度的平方根,避免高维情况下点积结果过大导致Softmax梯度消失。
- 加性注意力:通过一个小型神经网络计算得分,表达能力强但计算开销较大,常用于早期序列到序列模型。
理解这些基础形式,是进一步学习Transformer注意力机制和多头注意力机制的前提。对于刚接触深度学习入门的读者来说,建议先用手写小规模矩阵的方式验证一遍计算过程,再进入框架实现,这样对概念的理解会更加扎实。
三、Transformer注意力机制:多头注意力与位置编码
Transformer模型将注意力机制推向了新的高度。它完全抛弃了循环结构,仅依靠注意力机制和前馈网络完成序列建模。其中最具代表性的设计是多头注意力(Multi-Head Attention):将查询、键、值分别投影到多个子空间,在每个子空间中独立计算注意力,最后将结果拼接并线性变换。多头设计的意义在于,让模型能够同时从不同表示子空间中捕捉信息,例如一个头关注语法依赖,另一个头关注语义关联。
由于Transformer不含循环结构,本身无法感知序列顺序,因此需要引入位置编码(Positional Encoding)。常见做法是使用正弦余弦函数生成位置向量,或采用可学习的位置嵌入。位置编码与词嵌入相加后输入模型,使注意力机制在计算权重时能够区分不同位置的token。这一设计细节在实际工程中经常被忽视,但直接影响模型对序列顺序的敏感度。
此外,Transformer中的残差连接、层归一化和前馈网络同样是保证训练稳定的关键。很多开发者在复现Transformer注意力机制时只关注注意力计算本身,却忽略了这些配套结构,导致模型难以收敛。建议在实现时严格按照原论文结构搭建,再逐步做消融实验。
四、注意力机制在信息检索与推荐系统中的应用
注意力机制的价值不仅体现在生成式模型中,在信息检索技术领域同样有广泛应用。传统检索模型依赖词频、逆文档频率等统计特征,难以捕捉查询与文档之间的语义匹配关系。引入注意力机制后,模型可以动态地为查询中的不同词项分配权重,并对文档中的相关片段进行聚焦,从而提升检索的相关性排序质量。
在推荐系统中,注意力机制常用于建模用户历史行为序列。用户的行为序列往往长短不一、噪声较多,通过注意力加权,模型可以识别出对当前推荐最有参考价值的历史行为,而不是简单地对所有行为做平均池化。这类思路在电商、内容平台和广告系统中都有成熟落地案例,也是信息技术服务企业在构建大数据与人工智能平台时常用的技术方案。
五、注意力机制与元学习算法、强化学习的结合
元学习算法关注的是“学会学习”,即让模型在少量样本上快速适应新任务。注意力机制在元学习中可以作为任务特征的动态聚合器,帮助模型在不同任务之间快速定位可迁移的知识。例如在少样本分类中,通过注意力机制对支持集样本进行加权,能够有效提升原型表示的判别能力。
在强化学习领域,注意力机制同样发挥着作用。智能体面对高维观测输入时,需要从大量无关信息中提取关键状态特征。引入注意力机制后,智能体可以对观测中的不同区域或不同传感器信号分配不同权重,从而提升策略学习的效率和稳定性。对于使用AirSim仿真或无人机仿真平台进行强化学习训练的团队来说,注意力机制可以帮助智能体更好地聚焦于障碍物、目标点和飞行姿态等关键视觉信息,减少仿真环境中的视觉冗余干扰。
六、动手实践:从Fast.ai教程到仿真平台验证
理论理解之后,实践是巩固注意力机制知识的最好方式。对于希望快速上手的开发者,Fast.ai教程提供了自顶向下的学习路径,可以先从训练一个基于注意力的文本分类模型开始,再逐步深入到注意力权重的可视化分析。通过观察注意力热力图,能够直观感受到模型在不同输入位置上的聚焦差异,这对调试模型和理解失败案例非常有帮助。
在计算机视觉与机器人方向,AirSim仿真和无人机仿真平台为注意力机制的验证提供了贴近真实的实验环境。开发者可以在仿真中采集图像序列,构建基于注意力机制的感知模块,观察模型在复杂场景下的表现。相比真实飞行测试,仿真平台成本低、可重复性强,适合快速迭代算法原型。对于从事系统集成与技术支持的企业而言,这类仿真验证能力也是承接智能无人系统项目的重要技术储备。
七、学习注意力机制的常见误区与建议
- 只记公式不理解动机:注意力机制的本质是动态加权,理解“为什么加权”比背下Softmax公式更重要。
- 忽视计算复杂度:标准注意力机制的计算复杂度与序列长度的平方成正比,长序列场景需要考虑稀疏注意力、线性注意力等改进方案。
- 过度迷信注意力可视化:注意力权重高并不完全等同于模型决策依据,需结合梯度分析和消融实验综合判断。
- 缺少工程配套:实际部署中,注意力模块的显存占用和推理延迟需要纳入优化考量,尤其是在边缘设备上。
建议的学习路径是:先掌握计算机科学基础中的线性代数与概率论,再理解注意力机制的数学形式,随后通过Fast.ai教程或主流深度学习框架完成代码复现,最后结合信息检索、强化学习或仿真平台的具体任务做应用验证。这条路径兼顾理论与工程,适合不同背景的开发者循序渐进。
八、结语
注意力机制从提出到成为深度学习的基础组件,经历了从序列到序列模型中的辅助结构,到Transformer核心引擎的演变。它不仅是自然语言处理的关键技术,也在信息检索、推荐系统、元学习算法和强化学习等领域持续释放价值。对于信息传输、软件和信息技术服务行业的从业者来说,掌握注意力机制的原理与实践,是构建智能化软件平台、大数据分析系统和人工智能应用的重要能力。创智数据科技将持续围绕深度学习入门、Transformer注意力机制、信息检索技术与仿真平台应用等方向输出技术内容,帮助开发者在人工智能技术服务的实践中少走弯路。